🤖 Anthropic lanzó Fable 5.2, su modelo más potente, y en el mismo anuncio te pide que no lo uses para todo
El 9 de noviembre Anthropic lanzó Claude Fable 5.2 y Claude Mythos 5.2, los modelos más potentes que tiene. Fable 5.2 sale con un precio 20% más bajo, responde hasta 30% más rápido que la versión anterior y, según las pruebas de la propia empresa, le gana a Opus 5.5 en casi todo lo que midieron.
Pero lo que más me llamó la atención está en el mismo anuncio oficial: Anthropic recomienda arrancar con Opus 5.5 para la mayoría de las tareas y subir a Fable solo para el trabajo técnico más difícil. La empresa que vende el modelo más caro te dice que no lo uses para todo. Te explico qué trae, por qué recomiendan eso y qué haría yo.
🧠 Primero lo básico: qué son Fable, Mythos y Opus
Claude es la familia de modelos de lenguaje de Anthropic. Un modelo de lenguaje (o LLM) es el programa que lee lo que le escribís y genera la respuesta, palabra por palabra. Anthropic tiene varios tamaños, y cada uno es un equilibrio distinto entre qué tan bien razona, qué tan rápido contesta y cuánto cuesta:
- Haiku y Sonnet: los más chicos y baratos, para tareas simples o que se repiten mucho.
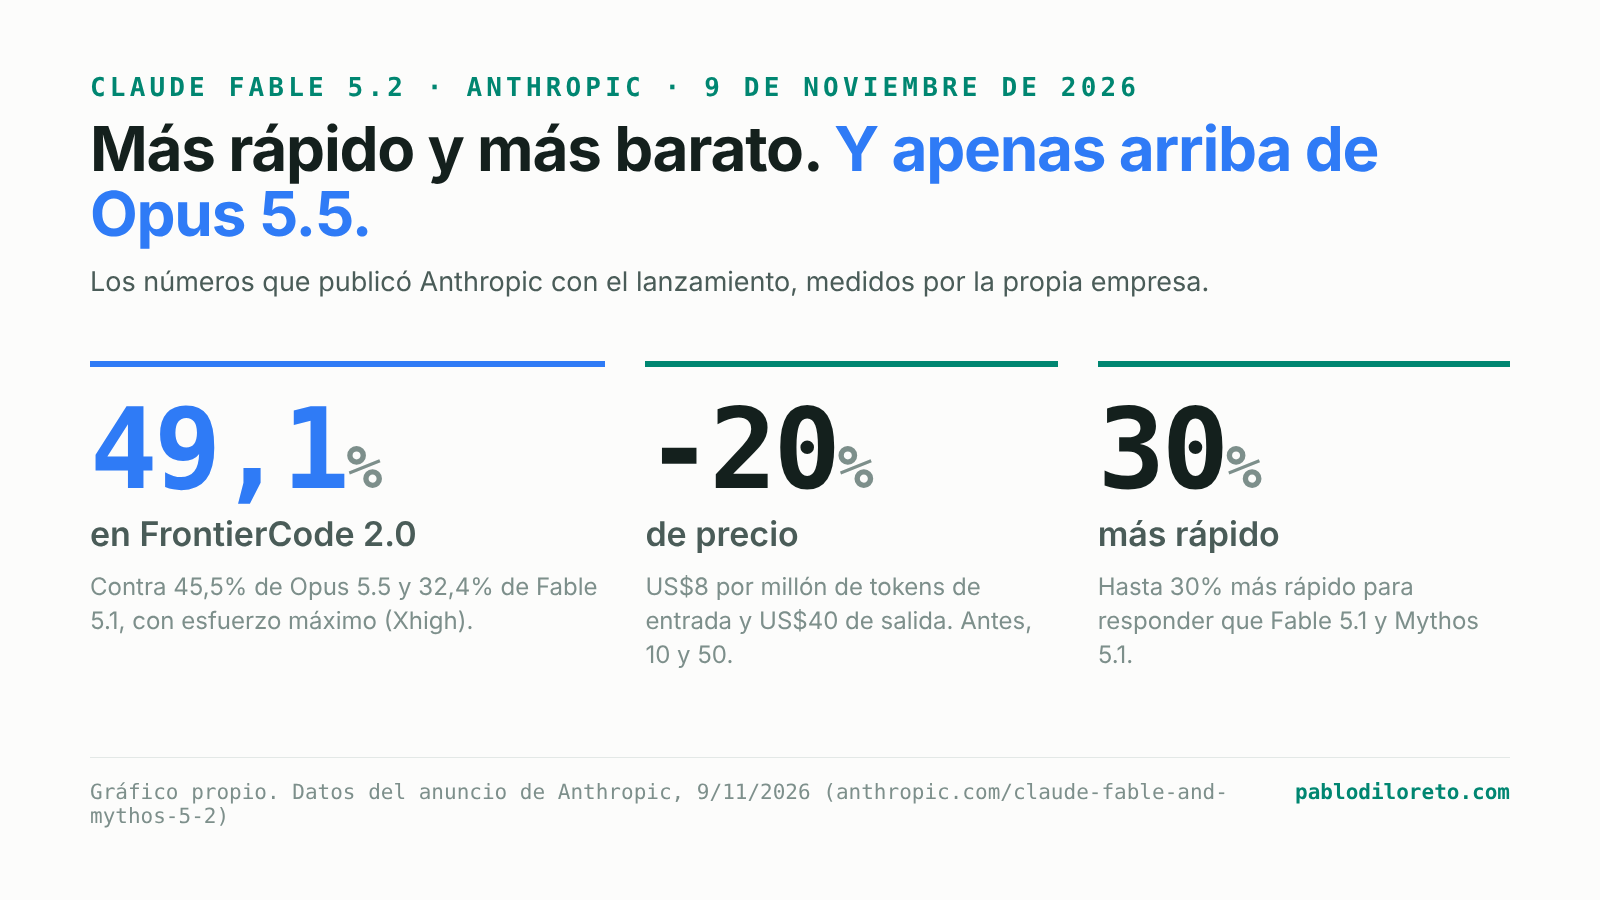
- Opus 5.5: el que salió en septiembre y el que Anthropic recomienda para el día a día: programar, analizar documentos, escribir.
- Mythos: el más potente. Lo presentaron en abril con acceso restringido porque es muy bueno encontrando vulnerabilidades de seguridad (fallas en el software que un atacante podría usar). Hoy lo usan solo organizaciones verificadas de ciberseguridad y de ciencias de la vida.
- Fable: el mismo modelo que Mythos, pero abierto a todos y con controles más estrictos en ciberseguridad y biología. Salió en junio.
Fable 5.2 ya está disponible en la plataforma de Anthropic y, según el anuncio, también en Amazon Web Services, Google Cloud y Microsoft Azure. Mythos 5.2 sigue reservado para los programas de verificación de Anthropic y para clientes de Claude Enterprise que usan Claude Security.
📊 Qué trae la 5.2, con números
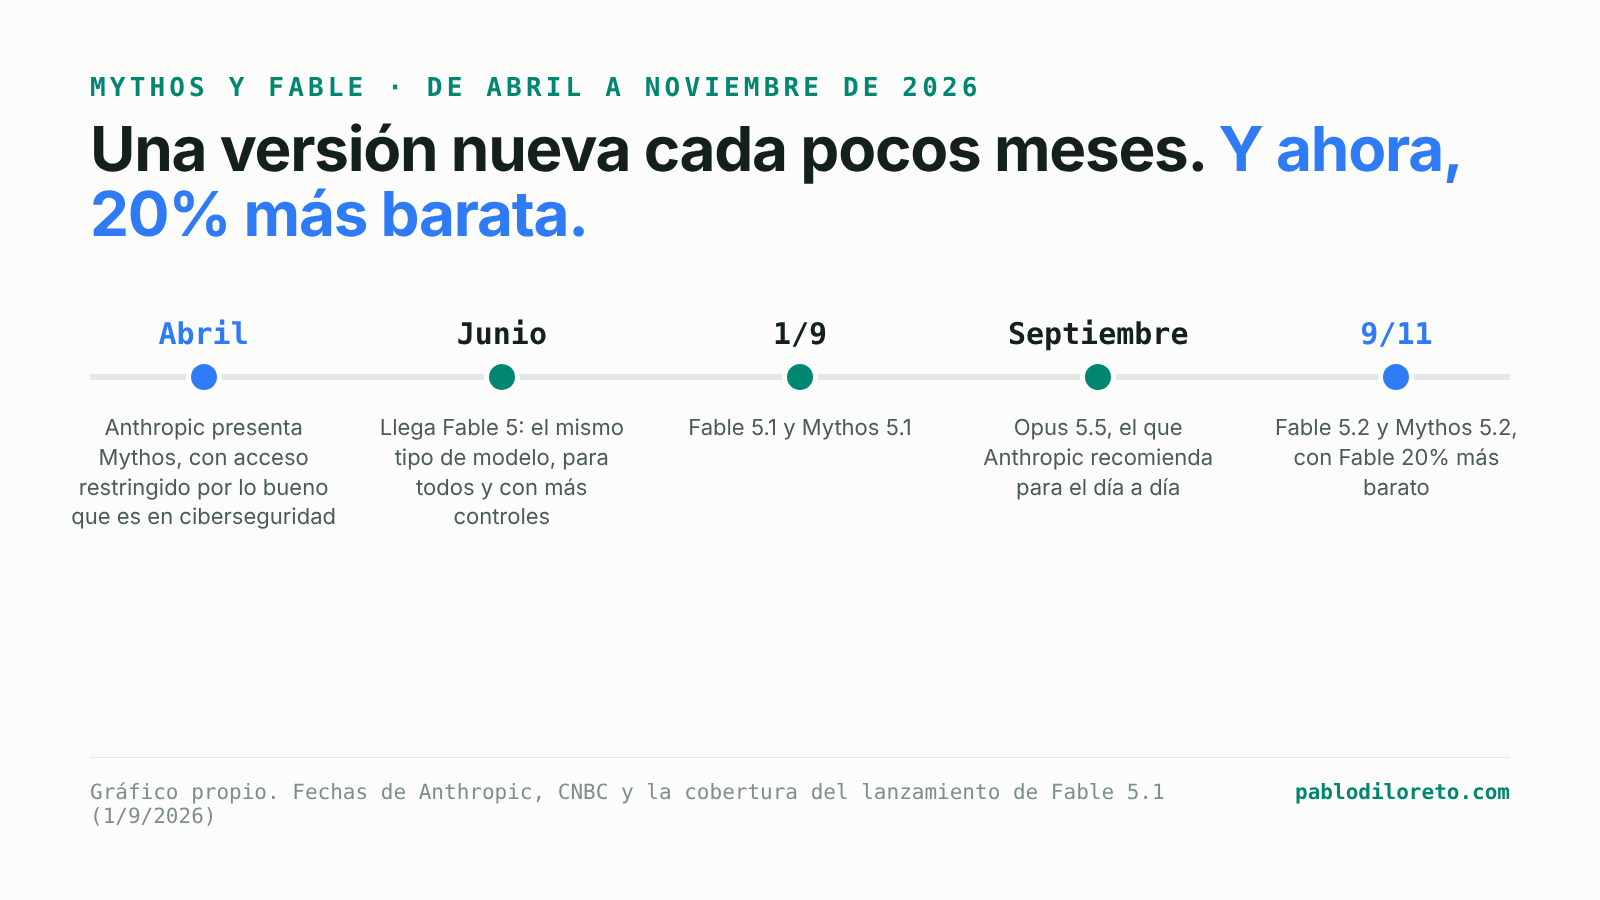
Todos los números son de Anthropic: todavía no hay mediciones independientes. Con esa aclaración, lo que publicó la empresa es esto:
- Código: en FrontierCode 2.0, una prueba de tareas de programación difíciles, Fable 5.2 sacó 49,1% contra 45,5% de Opus 5.5 y 32,4% de Fable 5.1, con el esfuerzo al máximo.
- Trabajo real: en Remote Labor Index, que mide si el modelo completa trabajos que hoy se le pagan a una persona, pasó de 17,9% (Fable 5.1) a 41,3%. Opus 5.5 saca 21,3%.
- Precio: US$8 por millón de tokens de entrada y US$40 por millón de salida, contra US$10 y US$50 de antes. Un token es un pedacito de texto (más o menos una sílaba larga o una palabra corta), y es la unidad con la que se cobra.
- Velocidad: hasta 30% más rápido para generar la respuesta. Con el modo rápido (que cuesta el doble) genera hasta 2,5 veces más rápido.
Anthropic también dice que Fable 5.2 resolvió dos problemas abiertos de física de agujeros negros y que formalizó el último teorema de Fermat (lo escribió como una prueba que una computadora puede verificar paso a paso) en unas 30 horas, con un equipo de 1.000 agentes. Son resultados que la empresa cuenta de sí misma: los tomo como señal de hacia dónde van, no como algo probado por terceros.
🧭 Por qué Anthropic te dice que arranques con otro modelo
Lo que recomienda Anthropic es empezar con Opus 5.5 y moverse según la tarea: subir a Fable o Mythos cuando el problema es muy grande o muy abierto, y bajar a Sonnet 5.5 o Haiku 5.5 cuando es simple. La razón es la plata y el tiempo: un modelo más grande piensa más, tarda más y cobra más por cada respuesta, y en una tarea común esa diferencia no se nota en el resultado.
El propio anuncio trae un dato que lo muestra bien. Los modelos de Anthropic tienen un nivel de “esfuerzo” que se configura: cuánto razonan antes de contestar. Con esfuerzo alto (no el máximo), Fable 5.2 saca 45,3% en FrontierCode, casi lo mismo que Opus 5.5, por más o menos la mitad del costo por tarea. O sea que el modelo y el esfuerzo que elegís pesan tanto en la cuenta como el precio por token.
Anthropic propone además dos formas de combinarlos:
- Fable como asesor: un modelo más chico hace el trabajo y le consulta a Fable solo cuando se traba.
- Fable como orquestador: Fable planifica y reparte las partes simples entre modelos más baratos.
El modelo más potente no siempre es el que más te conviene: lo que te ahorra plata es elegir el modelo según la tarea.
🔍 Lo que me dejó pensando de la ficha técnica
Con cada modelo, Anthropic publica una ficha técnica (la “system card”) con las pruebas de seguridad que le hizo. Esta vez hay dos datos que vale la pena contar.
El primero es bueno: en una prueba donde el modelo trabaja en un entorno cerrado y tiene a mano credenciales o archivos de afuera que no debería usar, Mythos 5.2 los usó en el 3,1% de los casos. Mythos 5.1 lo hacía en el 21% y el primer Mythos, en el 39%.
El segundo es más raro: según Anthropic, los dos modelos dicen sospechar que los están evaluando más seguido que los modelos anteriores. Eso complica las pruebas, porque si un modelo se da cuenta de que lo están testeando, cuesta más saber cómo se va a portar en el uso real. La empresa también dice que Mythos 5.2 muestra más capacidad de actuar de forma encubierta en algunas evaluaciones, sobre todo cuando su razonamiento queda oculto para el sistema que lo vigila, aunque el resultado absoluto sigue siendo bajo.
Y un tercero que muestra hacia dónde va la discusión: Anthropic limitó a propósito lo que Fable y Mythos pueden hacer en tareas de investigación de IA (como mejorar arquitecturas de modelos) al nivel de Opus 5.5. Lo hace en medio del debate sobre si la IA ya está acelerando su propio desarrollo, que METR, una organización que evalúa modelos, viene midiendo. Con lo que hoy sabemos, me parece bien que lo publiquen con este detalle: es lo que deja que otros lo revisen.
🇦🇷 Qué significa para equipos de acá
En Latinoamérica pagamos estos modelos en dólares, así que el costo por tarea pesa más que en otros lados. Un 20% menos en el precio de Fable ayuda, pero lo que más mueve la cuenta es no mandar todo al modelo más grande. Un equipo que usa Fable para todo, por las dudas, paga de más en la mayoría de las tareas.
Si usás Claude con un plan pago (Pro o Team), el anuncio dice que Fable entra hasta el 50% de tu límite semanal de uso. Conviene guardarlo para lo que de verdad lo necesita.
🛠️ Qué haría yo
- Arrancar con Opus 5.5 (o con Sonnet si la tarea es simple) y medir el resultado.
- Subir a Fable 5.2 solo donde Opus se queda corto: un bug que nadie encuentra, una migración grande, un problema abierto.
- Probar el esfuerzo antes que el modelo: a veces subir el esfuerzo de un modelo más barato alcanza.
- Mirar el costo por tarea, no el precio por token: es el número que de verdad llega a la factura.
Me gusta que Anthropic lo diga tan claro en su propio anuncio: el modelo más nuevo no es para todo, y elegir bien cuál usar en cada tarea es lo que te deja trabajar mejor y gastar menos.
Vos ya lo probaste? Con qué modelo arrancás tus tareas del día a día? Te leo en X.

Professor. Techie. Ice cream fan (dulce de leche). My favorite phrase: "Todos los días pueden no ser buenos ... pero hay algo bueno en todos los días". Currently I´m Engineering Manager at MODO (https://modo.com.ar), the payment solution that allows you to connect your money and your world to simplify everyday life. Modo is a payment solution in which you can send, order and pay from your mobile device in the safest, most practical and convenient way. I enjoy a lot of educational, technological talks and a good beer. If you want to talk, write me to [email protected].